10. Oktober 2026
•
Stammdaten & Dubletten
•
Philipp Begala
Dubletten im Materialstamm finden, ein Durchgang nach dem anderen
Jedes Stammdatenteam weiß, dass sein Materialstamm Dubletten enthält, meist weil jemand über eine gestolpert ist. Hier liest du, wie du Dubletten im Materialstamm finden kannst, systematisch und zuerst mit einer Tabelle, und wo diese Methode an ihre Grenze kommt.
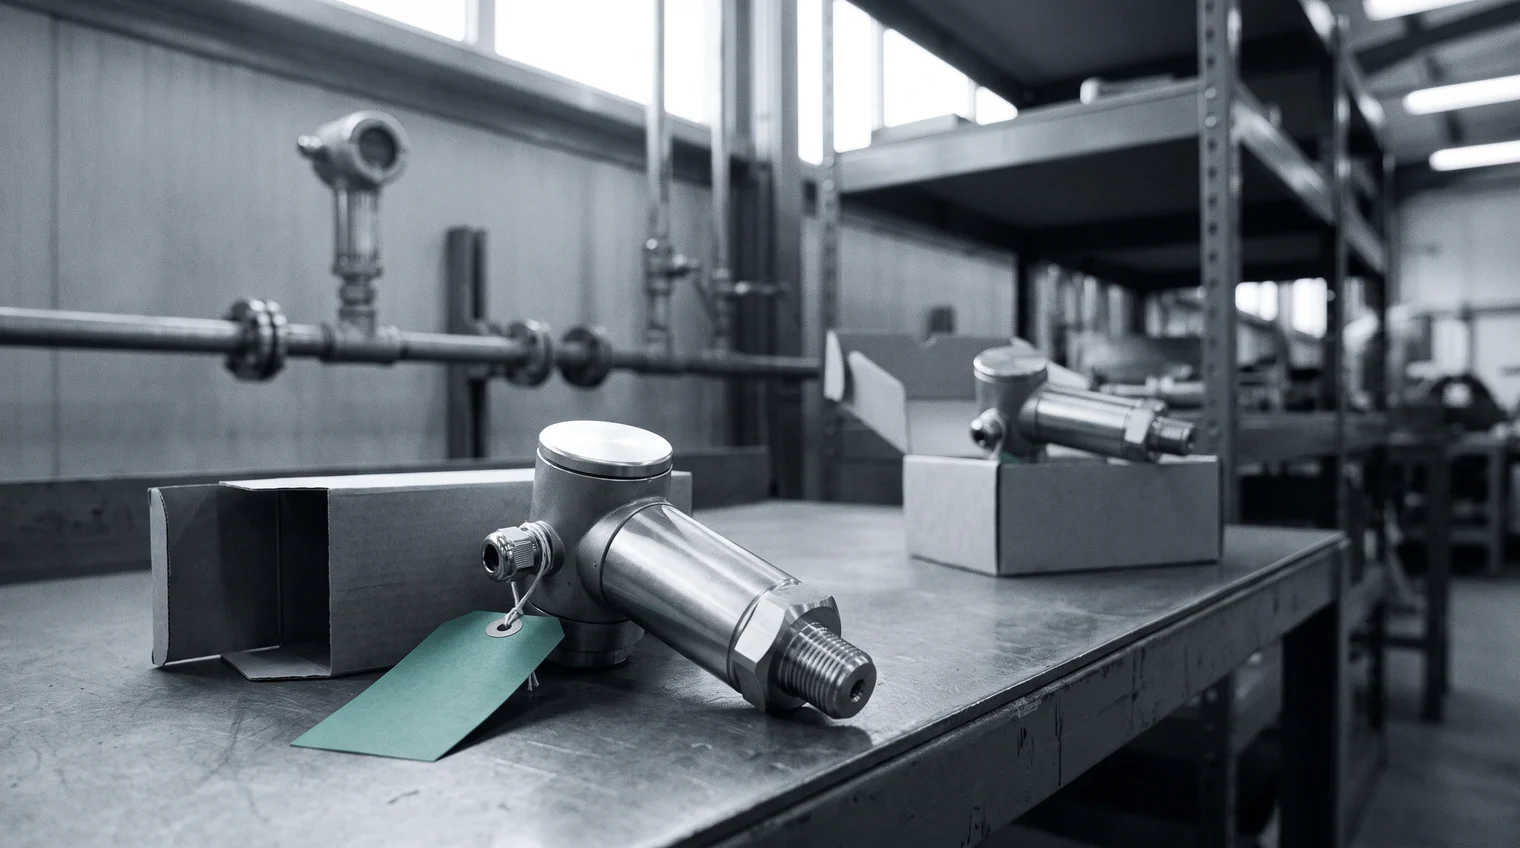
Der Einkauf in Ohio bestellt einen Druckmessumformer. Eine Woche später schickt das Ersatzteillager in Bremen denselben Messumformer an ein Schwesterwerk, aus einem Regal, in dem sechs Stück liegen. Niemand hat einen Fehler gemacht. Die beiden Werke kennen das Teil unter zwei Artikelnummern, und nichts im System sagt, dass es ein und dasselbe Teil ist.
Die meisten Stammdatenteams können so eine Geschichte erzählen. Dubletten gehören zum Job: Man findet sie und bereinigt sie, aber kaum jemand verfolgt sie als Zahl. Was dem Team meist fehlt, ist eine Methode, die alle findet, in einem Auszug mit Zehntausenden Zeilen, ohne gleich ein Projekt zu starten.
Wie aus einem Teil vier Datensätze werden
Dubletten entstehen nicht durch nachlässige Leute, sondern mit der Zeit. Dasselbe Teil kommt im Abstand von Jahren in den Materialstamm, über verschiedene Werke, angelegt von Menschen, die es jeweils gut beschreiben, in ihren eigenen Worten. Hier ist ein Druckmessumformer, wie er heute in einem Materialstamm steht.
Im Werk Bremen heißt er „DRUCKMESSUMFORMER 0-10BAR 4-20MA“, mit dem vollen Namen des Herstellers und der Teilenummer PT4410B2. Drei Jahre später legt jemand in Bremen „TRANSMITTER PRESSURE 10 BAR“ an, mit abgekürztem Herstellernamen und der Teilenummer in der Schreibweise PT-4410-B2. Im Werk Valencia heißt er „TRANSMISOR PRESION 0-10 BAR“, ganz ohne Hersteller, nur mit der Bestellnummer des Händlers. In Ohio heißt er „PRESS XMTR 0-145PSI 4-20MA“, ohne Teilenummer.

Vier Datensätze, drei Werke, ein Teil. Jeder Datensatz war richtig, als er angelegt wurde. Zusammen verstecken sie das Teil vor allen, die danach suchen, und genau diese Kosten zählen am meisten: Eine Studie der SUPSI in Lugano von 2026 fand, dass Dubletten und unvollständig beschriebene Datensätze vorhandene Teile „effectively undiscoverable“ machen, also praktisch unauffindbar (Bulloni et al., SUPSI, 2026, auf arXiv). Was das für Bestand und Ausgaben bedeutet, behandelt der Beitrag über die versteckten Kosten schlechter Ersatzteil-Stammdaten.
Dubletten im Materialstamm finden: drei Durchgänge
Du kannst heute anfangen, mit einem Auszug aus dem Materialstamm und einer Tabelle. Arbeite ihn in drei Durchgängen durch, den günstigsten zuerst:
- Exakte Herstellerteilenummer. Sortiere nach dem Feld für die Teilenummer und markiere jede Nummer, die mehr als einmal vorkommt. Das dauert Minuten, und jeder Treffer ist belastbar. Den Messumformer verfehlt dieser Durchgang ganz: PT4410B2 und PT-4410-B2 sind verschiedene Zeichenketten.
- Vereinheitlichte Teilenummer und Hersteller. Entferne Leerzeichen, Bindestriche, Punkte und Schrägstriche aus der Teilenummer, und schreib jeden Herstellernamen auf eine einzige Art. Jetzt passen die beiden Bremer Datensätze zusammen. Dieser Durchgang kostet einen Nachmittag, meist für die Einigung auf die Herstellernamen. Valencia verfehlt er trotzdem, denn dort steht die Nummer eines Händlers, und Ohio auch, denn dort steht gar keine.
- Kurztexte. Für die Datensätze, die die ersten beiden Durchgänge nicht erreichen, liest du die Kurztexte und vergleichst. Hier tauchen die letzten beiden Datensätze des Messumformers auf: ein spanischer Text, ein Messbereich in psi statt bar, eine Abkürzung, die sonst niemand verwendet. Hier hört die Methode auch auf zu skalieren. Durchgang drei ist Lesen, Zeile für Zeile, und in einem großen Materialstamm wird er nie fertig.

Mach die drei Durchgänge für eine Materialgruppe, bevor du etwas Größeres planst. Pumpen, Ventile oder Sensoren eignen sich gut, weil sie oft gekauft und auf viele Arten beschrieben werden. Das Ergebnis zeigt dir zwei Dinge: wie viele Dubletten die einfachen Durchgänge finden und wie viele Datensätze übrig bleiben, die sich nur durch Lesen klären lassen.
Warum die Dublettenerkennung von Hand an ihre Grenze kommt
Die ersten beiden Durchgänge hängen an einem Feld, das Dubletten oft nicht haben. Ein Datensatz mit einer Händlernummer oder ganz ohne Teilenummer erreicht sie nie. Das sind oft die Datensätze, die in Eile angelegt wurden, bei einem Ausfall oder für eine einmalige Bestellung, und genau dann entstehen Dubletten.
Der dritte Durchgang hängt an Menschen, und Menschen lesen Kurztexte so, wie sie sie schreiben. Der Ingenieur, der weiß, dass 145 psi 10 bar sind, liest vielleicht kein Spanisch. Die Kollegin, die Spanisch liest, kennt vielleicht den Hersteller hinter einer Händlernummer nicht. In einem gemessenen Fall bei einem Hersteller mit mehreren Standorten machten Dubletten etwa 9 % des Bestands aus (eine Fallstudie, veröffentlicht von Reliable Plant). Das ist ein Fall, kein Benchmark, aber er zeigt, wie viel in den Datensätzen stecken kann, die niemand gelesen hat.
Zwei weitere Probleme tauchen in jedem Team auf, das es so versucht. Erstens ist ein Treffer, der durch Lesen gefunden wurde, ein Urteil, und die nächste Person urteilt vielleicht anders. Eine Gruppe braucht eine Tatsache dahinter, bevor jemand Datensätze zusammenführt oder Bestand umlagert. Zweitens ändert sich der Auszug, während du arbeitest. Neue Datensätze kommen dazu, und manche davon sind die nächsten Dubletten. Die meisten beginnen mit einer erfolglosen Suche, die in einem neuen Datensatz endet, wie der Beitrag warum die Stichwortsuche Ersatzteile im Materialstamm verfehlt zeigt.
Gruppen, die du prüfen kannst, auf dem Materialstamm, wie er ist
Für den Rest des Materialstamms muss die Prüfung das Lesen für dich übernehmen und dir trotzdem etwas zum Nachprüfen geben. Partium Cockpit macht das mit dem Dubletten-Monitor. Der Dubletten-Monitor findet dasselbe Teil unter verschiedenen Artikelnummern. Beim Messumformer holt er die Datensätze aus Valencia und Ohio in die Gruppe, die die Tabelle nur zur Hälfte bilden konnte.
Eine Gruppe nützt nur, wenn du ihr vertrauen kannst, bevor du handelst. Der Dubletten-Monitor bestätigt jede Gruppe über die Herstellerteilenummer. Das Ergebnis liest sich wie die Tabelle, die du bauen wolltest. Jede Dublettengruppe listet die Artikelnummern auf, die ein und dasselbe Teil sind.
Nichts davon braucht einen sauberen Materialstamm als Ausgangspunkt. Deine Daten, so wie sie sind. Kein Bereinigungsprojekt, bevor du anfängst. Kurztexte, Dubletten, fehlende Hersteller und Kataloge in mehreren Sprachen sind genau die Eingaben, für die wir bauen.
Was zu tun ist, sobald eine Gruppe bestätigt ist, und wer zustimmt, bevor Bestand bewegt wird, ist ein eigener Schritt und ein eigener Beitrag. Für jetzt: Mach die drei Durchgänge für eine Materialgruppe und vergleiche dann, was du gefunden hast, mit dem, was der Dubletten-Monitor im selben Auszug findet. Buch dir eine Demo, oder frag nach der Demo-Lizenz und probier es mit deinem eigenen Materialstamm aus. Und wenn der Einkauf immer wieder Teile bestellt, die sich dann im Regal finden, lies warum der Einkauf Ersatzteile nachbestellt, die schon da sind.
Sieh es in deinem eigenen Katalog.
Buch dir eine Demo, oder starte mit einer Demo-Lizenz.
Mehr von Partium ...
9. Oktober 2026
Erst suchen, dann kaufen: Warum der Einkauf Ersatzteile nachbestellt, die schon da sind
Weiterlesen
12. Mai 2025