15 octobre 2026
•
Nettoyer le référentiel articles
•
Philipp Begala
Avant S/4HANA, trier les pièces de rechange : laisser, fusionner, compléter
Les données de base des pièces de rechange sont le pan le plus ancien du référentiel articles, et la migration vers S/4HANA est souvent la première fois depuis longtemps qu’on les relit toutes. Triez-les avant : à laisser, à fusionner, à compléter. Gardez les mêmes contrôles après la mise en production.
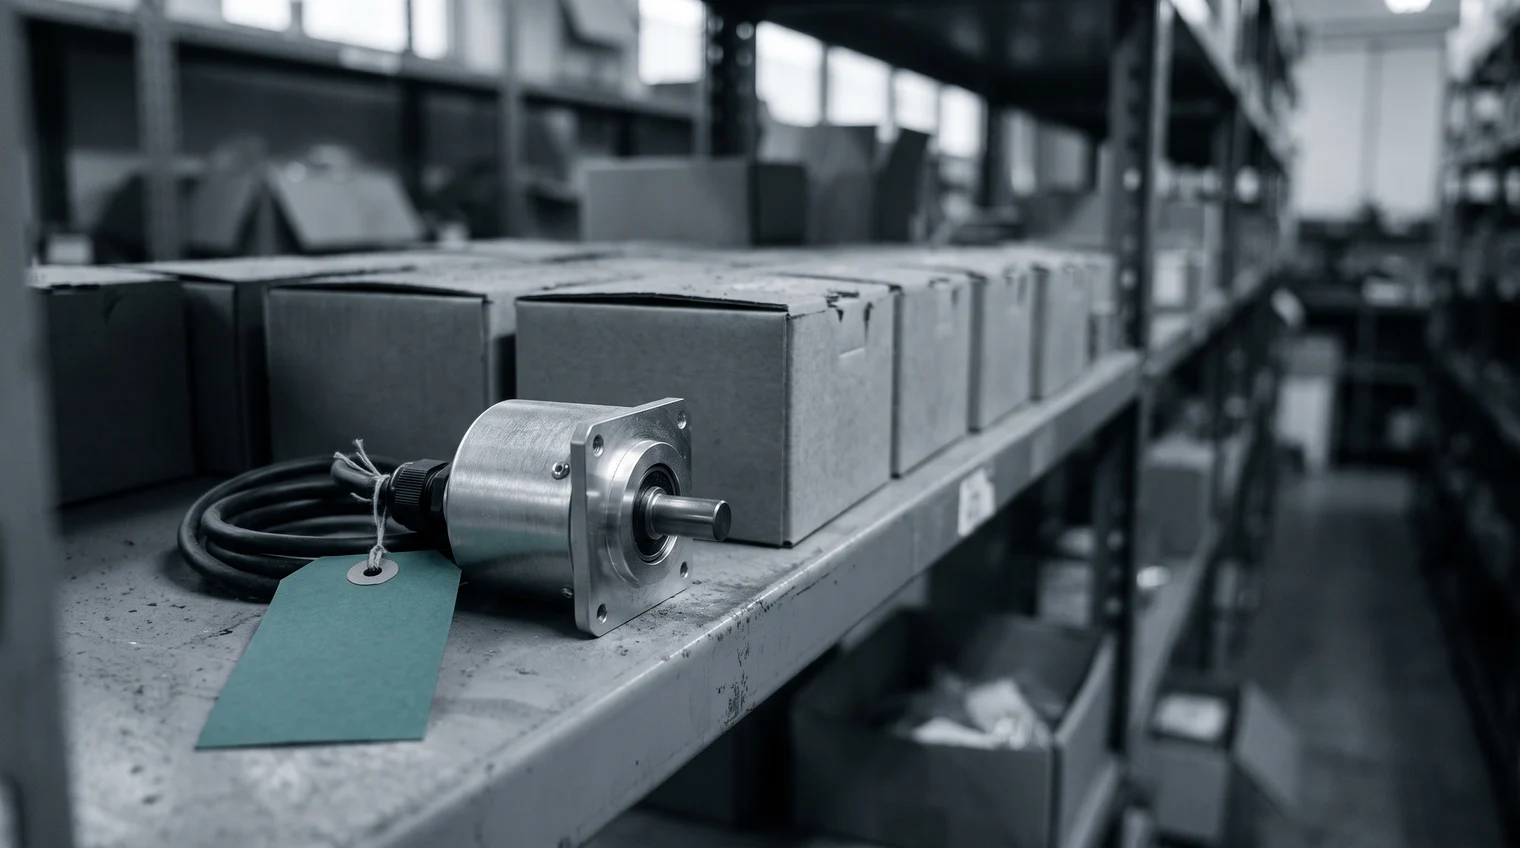
Les gestionnaires des données articles extraient d’ECC les pièces de rechange et trient l’extraction par texte court. Trois lignes désignent le même codeur rotatif. La première vient de l’usine dont le convoyeur tourne aujourd’hui avec ce codeur. La deuxième a été créée par une usine sœur, qui en avait acheté un de réserve sous son propre numéro. La troisième appartient à une usine fermée depuis des années, mais dont les fiches figurent toujours dans le référentiel. Sans décision contraire, les trois partiront dans S/4HANA.
Avec S/4HANA, on relit enfin toutes les pièces de rechange
Le passage de SAP ECC à S/4HANA est acté et budgété, et le référentiel articles fait partie du projet. Les pièces de rechange en sont la partie que personne ne parcourt d’un bout à l’autre au quotidien. La maintenance cherche la pièce dont elle a besoin, les achats commandent ce qu’ils parviennent à trouver, et une fiche que personne ne cherche disparaît des radars. La migration bouscule cette routine : chaque fiche de l’extraction doit être mappée, chargée et contrôlée. Pour une fois, quelqu’un les voit toutes.
Ce qu’on y découvre n’a rien de surprenant. Des articles inactifs que personne n’a touchés depuis des années. La même pièce sous plusieurs numéros, créée dans différentes usines par des gens qui l’ont tous bien décrite, mais chacun à sa façon. Et des textes courts réduits à « ENCODER », que aucun technicien ne retrouvera en cherchant. Un cas mesuré va dans le même sens : en 2024, un mémoire de master de l’Université de Lund a analysé les pièces de rechange d’un OEM à partir de ses données ERP, et ses auteurs en ont conclu que le système devait être nettoyé.
Migrer ces fiches en l’état, c’est emporter leurs coûts dans le nouveau système : la pièce achetée deux fois parce que la première était rangée sous un autre numéro, la réparation bloquée en attendant une pièce introuvable, les heures passées à rapprocher des fiches à la main. Le total de ces coûts est détaillé dans notre article sur les coûts cachés des données articles de mauvaise qualité. La migration est le moment où le budget permet enfin de s’y attaquer. Ce ne sera pas la dernière fois qu’ils apparaissent ; la dernière partie y revient.
Données de base des pièces de rechange avant S/4HANA : décider en trois groupes
Un outil de migration transfère des fiches ; il ne décide pas lesquelles doivent exister. Cette décision revient à ceux qui connaissent les pièces, et elle se prend avant le chargement. Elle est aussi plus facile à prendre par groupe de fiches que ligne à ligne. Répartissez l’extraction des pièces de rechange en trois groupes :
- Laisser de côté. Les fiches sans mouvement, sans stock et sans équipement installé qui utilise la pièce. Elles ne sont pas chargées, dès que la maintenance a confirmé par sa signature qu’aucune machine n’en a plus besoin.
- Fusionner. Les fiches qui décrivent une même pièce sous des numéros différents. Une seule est conservée et récupère le stock et les données usine des autres ; les autres sont bloquées, pour que plus personne ne commande sous ces numéros.
- Compléter. Les fiches dont dépendront la prochaine recherche et la prochaine commande, mais qui n’indiquent pas le fabricant, la référence fabricant ou les attributs qui distinguent une variante d’une autre. Elles migrent une fois ces champs renseignés.
Le codeur rotatif montre les trois décisions à l’œuvre. L’article 300871, dans l’usine fermée, a pour texte court « ENCODER », aucune référence et plus aucun mouvement depuis la fermeture. Il est laissé de côté dès que la maintenance confirme que ce codeur n’est monté nulle part ailleurs. L’article 140552, dans l’usine sœur, a pour texte court « DREHGEBER 1024 IMP 10MM », une référence fabricant écrite avec des tirets et deux pièces en stock. C’est le même codeur que celui de la fiche de l’usine des convoyeurs : il est donc fusionné dans cette fiche, et ses deux codeurs deviennent un stock que les deux usines voient. C’est à repérer des paires comme celle-ci que passe l’essentiel des heures. L’article 100917, dans l’usine des convoyeurs, est la fiche conservée ; il migre une fois complet : fabricant, référence fabricant sous une seule forme, résolution, diamètre de l’arbre et signal de sortie. Numéros d’article et textes sont propres à l’exemple.
L’ordre a son importance. Laisser d’abord de côté les fiches mortes allège la fusion : un doublon dans une usine fermée n’a plus à être fusionné. Fusionner avant de compléter évite de remplir trois fois les mêmes champs : l’équipe ne le fait qu’une fois, sur la fiche conservée. Enfin, chaque groupe a son signataire. La maintenance valide ce qui est laissé de côté, le magasin maintenance et les achats valident ce qui est fusionné, et l’équipe des données articles répond de ce qui est complété.

Un tri qui doit tenir dans le calendrier de la migration
À l’échelle d’une usine, l’extraction se trie à la main. À l’échelle d’un groupe, avec des dizaines de milliers de fiches de pièces de rechange réparties entre usines et langues, ce n’est plus possible, d’autant que la migration suit des échéances que l’équipe des données articles ne fixe pas. Un tri par mouvement et par stock fait ressortir l’essentiel du premier groupe en un après-midi. Pour le deuxième et le troisième, il faut quelqu’un pour lire des textes courts, comparer des références écrites de trois façons et décider des attributs nécessaires à chaque type de pièce. C’est dans cette lecture qu’un tri manuel finit par manquer de temps.
Partium Cockpit, c’est là que l’équipe mène ce travail de lecture. La classification range chaque pièce de votre catalogue dans sa classe le jour même où vous le chargez. Chaque fonctionnalité de Cockpit part de ces classes. Concrètement, le codeur rejoint sa classe le jour où l’extraction est chargée, et la classe fixe les attributs qu’une fiche complète doit porter. Le dédoublonnage repère la même pièce enregistrée sous plusieurs numéros et empêche une nouvelle fiche d’ajouter un doublon de plus. Le DREHGEBER de l’usine sœur et le codeur de l’usine des convoyeurs ressortent ensemble, comme un seul groupe ; la fusion, elle, reste une décision de l’équipe. Les champs se remplissent dans l’Enrichissement ciblé des attributs. Le tableau complet des résultats accepte les corrections directement et en masse : l’IA propose, votre équipe corrige. Proposition et décision restent distinctes : chaque champ rempli sur la fiche du codeur est un champ que l’équipe a validé.
Après la mise en production, le référentiel évolue et les contrôles restent
Le jour où S/4HANA entre en production, le référentiel des pièces de rechange est plus propre qu’il ne le sera jamais. Dès le lendemain matin, un acheteur d’une usine sœur crée une fiche pour une pièce qu’il n’a pas trouvée, et une nouvelle machine arrive avec sa liste de pièces de rechange. Un nettoyage mené une seule fois, pour la migration, commence à vieillir dans la semaine. Les équipes données articles qui ont déjà nettoyé leur référentiel connaissent la suite : l’argent part d’un coup, puis la dégradation reprend. Ce travail au long cours fait l’objet de notre guide sur le nettoyage du référentiel articles.
Les contrôles qui ont servi à trier l’extraction sont ceux dont le nouveau référentiel a besoin tous les jours : une classe pour chaque nouvelle pièce, une recherche de doublons avant l’enregistrement d’une nouvelle fiche et, avant toute commande, les champs utiles à la recherche déjà renseignés. Votre ERP reste le système de référence. Partium Agent y lit les données et y réécrit ce que votre équipe décide. Avec cette routine, le codeur reste une seule fiche après la mise en production, et la prochaine migration ne repartira pas de la même extraction.

Commencez cette semaine par une seule usine. Extrayez ses pièces de rechange et répartissez-les en trois groupes : sans mouvement ni stock ; une même référence fabricant sous deux numéros d’article ou plus ; des pièces en service sans fabricant ou sans référence. Comptez chaque groupe, puis soumettez la première liste à la maintenance pour signature. Ces trois chiffres mesurent l’ampleur de la décision que votre migration s’apprête à prendre. Pour appliquer le même tri à cette extraction, réservez une démo : nous vous le montrons sur notre catalogue de démonstration ou sur un échantillon de vos données.
Voyez-le sur un catalogue comme le vôtre.
Nous vous montrons Partium en direct, sur notre catalogue de démonstration ou sur un échantillon du vôtre.